System-One-Modelle: Wann sich Jev statt LLM lohnt
Ein Praxis-Leitfaden am Beispiel von Jev — und warum die Confidence wichtiger ist als die Geschwindigkeit.

Das Wichtigste in Kürze
- Jev ist ein Modell von TypeSafe AI (San Francisco, gegründet 2024), seit 15. September 2026 in begrenztem Early Access. Tier 2
- Es kennt drei Fragetypen: Choice (bis zu 255 Optionen), Score und Noul (Ja/Nein als Wahrscheinlichkeit). Tier 1
- Antwortzeit 70–500 ms, Preis 0,042 US-Dollar je Million Input-Tokens, Output wird nicht separat verrechnet. Tier 1Tier 3
- Die vielzitierte Zuschreibung „von einem ChatGPT-Mitgründer“ stimmt so nicht: CEO Diogo Almeida war rund vier Jahre bei OpenAI und arbeitete an RLHF, InstructGPT, ChatGPT und GPT-4 — Mitgründer von ChatGPT war er nicht.
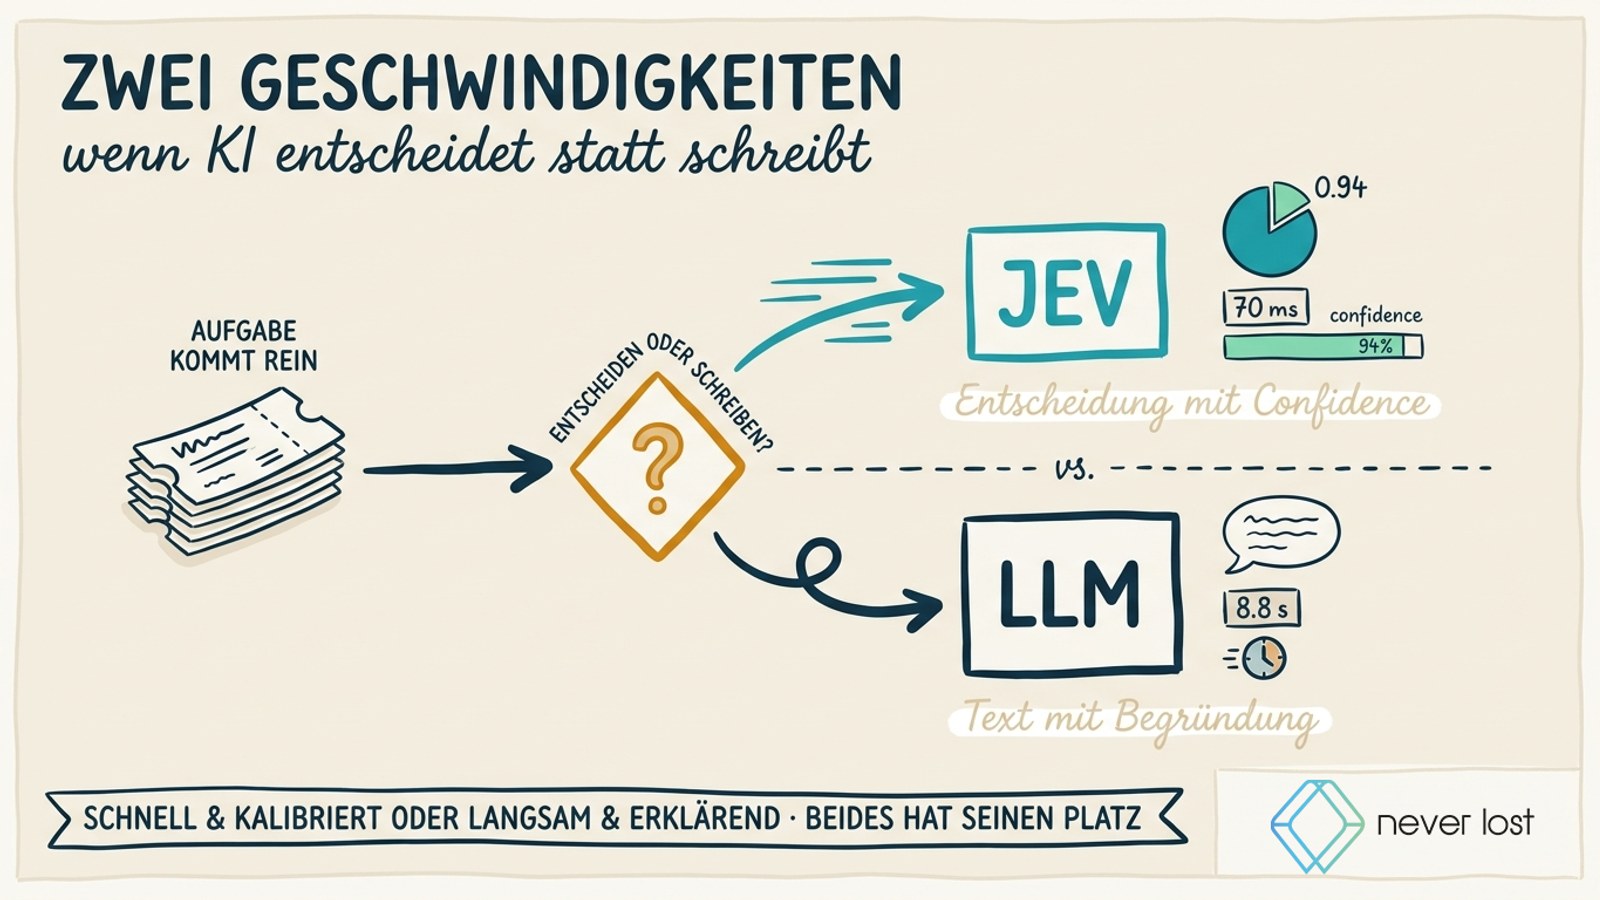
- In einem externen Test an 12 Textpassagen fand Jev 6 von 7 Fehlern in rund 0,35 Sekunden; ein Frontier-Modell fand alle 7 in rund 8,83 Sekunden. Tier 3
- Die praktisch wichtigste Zahl stammt aus einem zweiten Test an Rechtsdokumenten: 82,9 % Trefferquote insgesamt, 93,7 % wenn man nur Antworten ab 95 % Confidence gelten lässt.
- Vor einem Produktivsetzen gehört eine eigene Kalibrierungsmessung an eigenen Daten — die Herstellerbenchmarks sind ausdrücklich als möglicherweise selektiv gekennzeichnet.
Ein System-One-Modell wie Jev schreibt keinen Text, sondern beantwortet typisierte Fragen gegen einen übergebenen Zustand: eine Auswahl, eine Punktzahl, ein Ja/Nein, jeweils mit Wahrscheinlichkeitsverteilung und Confidence-Wert. Sinnvoll ist das überall dort, wo in einem Workflow dieselbe kleine Entscheidung tausendfach fällt und heute ein teures Sprachmodell dafür herhalten muss. Der eigentliche Hebel ist dabei die Confidence: Das Modell legt offen, wie sicher es sich ist, und daraus lässt sich eine belastbare Grenze zwischen „automatisch“ und „Mensch schaut drauf“ bauen.
In fast jeder Prozessanalyse, die wir bei never lost machen, taucht dasselbe Muster auf: Ein Arbeitsablauf besteht zum größten Teil aus winzigen Weichenstellungen und nur zu einem kleinen Teil aus echter inhaltlicher Arbeit. Ist dieser Reklamationsfall dringend? In welche Warteschlange gehört diese Nachricht? Ist dieses Dokument vollständig? Soll hier ein Mensch draufschauen?
Seit dem breiten Einzug der Sprachmodelle erledigt in vielen Unternehmen ein einziges großes Modell beides: die Weichenstellungen und die inhaltliche Arbeit. Das funktioniert, ist aber ungefähr so, als würde man jeden Brief mit einem LKW zustellen.
Seit September 2026 gibt es dafür eine eigene Produktkategorie. Ihr erster sichtbarer Vertreter heißt Jev und kommt von TypeSafe AI. Dieser Beitrag ist kein Produkt-Review. Er beantwortet die Frage, die uns seit der Veröffentlichung mehrfach gestellt wurde: Wo in meinem Ablauf würde so etwas etwas bringen, und woran erkenne ich, dass es nichts bringt?
Was ist ein System-One-Modell überhaupt?
Der Name spielt erkennbar auf Daniel Kahnemans Unterscheidung an: System 1 entscheidet schnell und intuitiv, System 2 denkt langsam und analytisch. Eine offizielle Herleitung des Begriffs habe ich in der Dokumentation nicht gefunden. TypeSafe ordnet Jev entsprechend als „erstes System-One-Modell“ ein — ein Modell, das schnelle, strukturierte Entscheidungen trifft, die Software direkt weiterverarbeiten kann. Tier 1
Praktisch bedeutet das: Sie übergeben einen Zustand, also eine E-Mail, ein Dokument oder einen Datensatz, und dazu eine oder mehrere typisierte Fragen. Zurück kommt ein Wert. Drei Typen stehen zur Verfügung:
- Choice — eine Auswahl aus bis zu 255 Optionen, mit Wahrscheinlichkeitsverteilung und Confidence
- Score — eine Punktzahl auf einer definierten Skala, ebenfalls mit Verteilung und Confidence
- Noul — ein Wahrheitswert zwischen 0 und 1, also ein Ja/Nein mit Wahrscheinlichkeit
Der entscheidende architektonische Unterschied: Es gibt kein Parsing. Sie müssen keine JSON-Antwort aus einem Textfluss herausschälen und hoffen, dass das Modell diesmal keine Erklärung davorschreibt. Jeder, der schon einmal einen Retry-Mechanismus für kaputtes Modell-JSON gebaut hat, weiß, wie viel Code das spart.
Dazu kommt ein Detail, das in der Praxis mehr ausmacht als die reine Geschwindigkeit: Mehrere Fragen werden in einer Anfrage parallel gegen denselben Zustand ausgewertet. Laut Dokumentation ändert sich die Antwortzeit kaum, wenn man Fragen hinzufügt. Zwanzig Prüffragen an ein Dokument kosten damit ungefähr so viel Zeit wie eine.
Warum können Sprachmodelle das nicht einfach auch?
Funktional können sie es. Jedes aktuelle Sprachmodell lässt sich so anweisen, dass es eine Kategorie zurückgibt und eine Selbsteinschätzung dazu formuliert. Der Unterschied liegt nicht im Können, sondern im Optimierungsziel.
Seit dem Erscheinen von ChatGPT Ende 2022 wurden Sprachmodelle darauf optimiert, Menschen im Dialog zu unterstützen. Ab 2025 kam ein zweites Optimierungsziel dazu: Coding-Agenten bedienen, die eigenständig Aufgaben abarbeiten. Beide Ziele haben eines gemeinsam. Sie setzen voraus, dass am anderen Ende jemand wartet, liest und bewertet.
Eine dritte Schicht wurde dabei nie ernsthaft bedient: die Automatisierung innerhalb von Software, dort wo tausendfach dieselbe kleine Entscheidung fällt und niemand mitliest. Genau an dieser Stelle setzt die These von TypeSafe an. Nicht die Intelligenz der Modelle sei dort das Problem, sondern dass sie für eine andere Aufgabe gebaut wurden.
Der technische Kern dieser These liegt in der Architektur. Sprachmodelle arbeiten autoregressiv, sie erzeugen Token für Token, jedes auf Basis der vorherigen. Diese Struktur ist der Grund für ihre Qualität in längeren Texten und gleichzeitig der Grund, warum eine Antwortzeit von 70 Millisekunden für sie unerreichbar bleibt. Jev ist stattdessen auf paralleles Sampling und typisierte Wahrscheinlichkeitsentscheidungen ausgelegt. Tier 2
Was das praktisch bedeutet: Die drei Primitiven — Auswahl, Punktzahl, Ja/Nein — fühlen sich an wie eine Rückkehr auf eine tiefere Abstraktionsebene. Fast wie Logikgatter und Register, über die erst wieder Schichten gebaut werden müssen, damit etwas Nützliches entsteht. Das ist kein Rückschritt, sondern eine bewusste Entscheidung: kleine, schnelle, typsichere Bausteine statt eines Universalwerkzeugs.
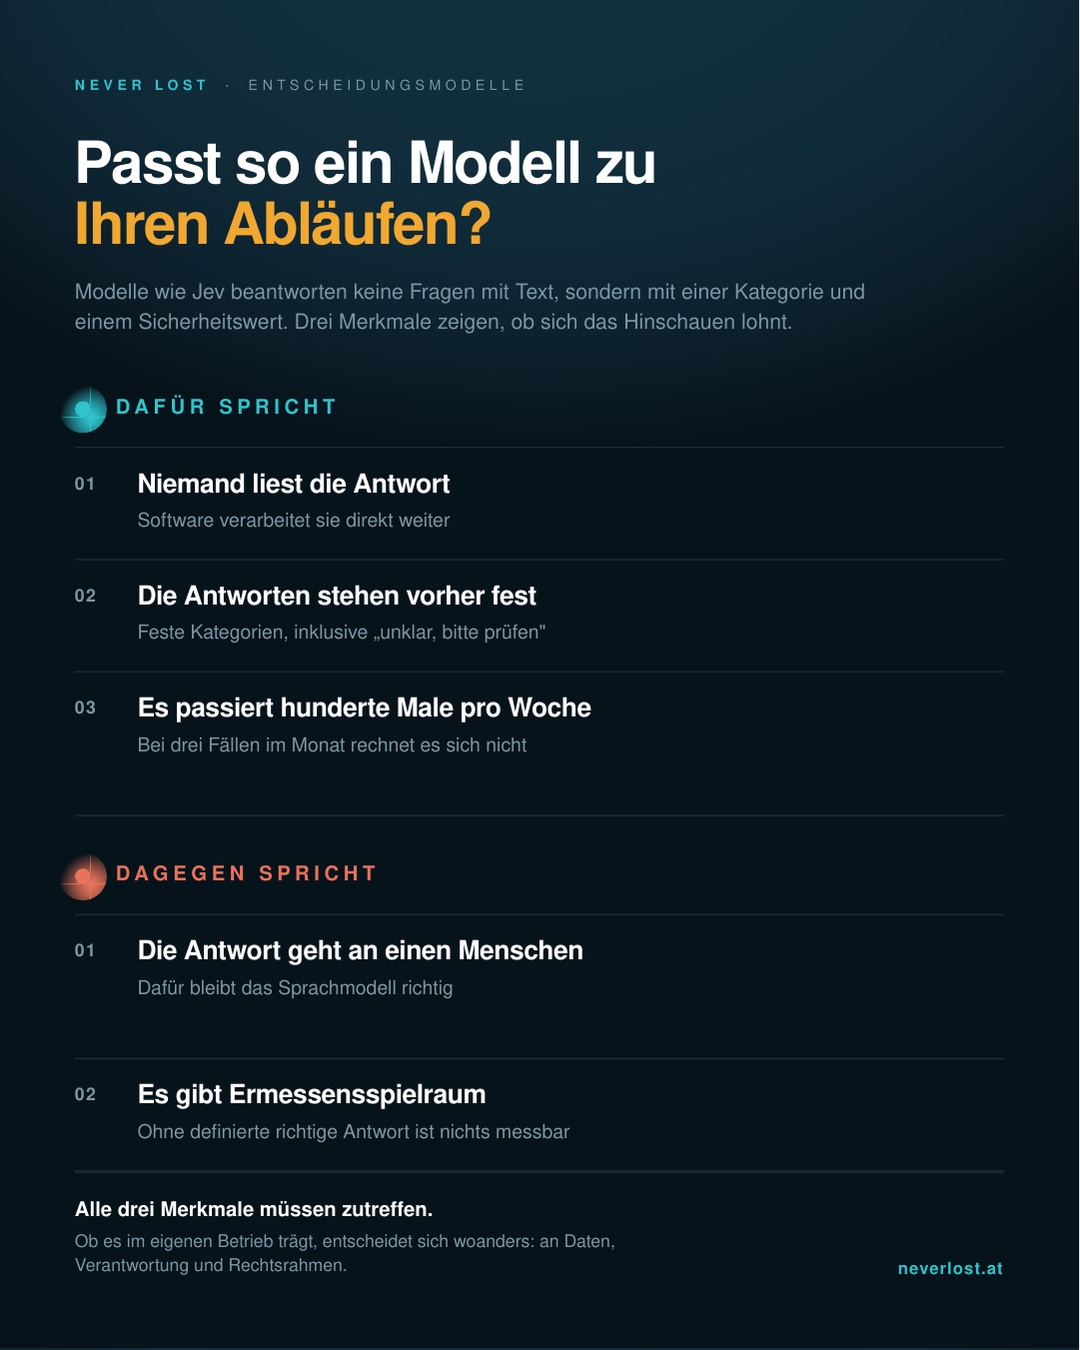
Für die Bewertung im eigenen Unternehmen folgt daraus eine nützliche Abkürzung. Wenn in einem Ablauf niemand die Antwort liest, sondern Software sie direkt weiterverarbeitet, ist das ein Hinweis auf einen Kandidaten. Wenn ein Mensch die Antwort liest und interpretiert, gehört die Aufgabe weiterhin an ein Sprachmodell.
Woher kommt Jev — und stimmt die Sache mit dem ChatGPT-Mitgründer?
Nein. Die Zuschreibung kursiert in mehreren Newslettern und Beiträgen, sie ist aber nicht korrekt.
TypeSafe AI wurde 2024 in San Francisco von Diogo Almeida (CEO), Erik Gafni und Sasha Sheng gegründet. Almeida war rund vier Jahre bei OpenAI und hat dort an Reinforcement Learning from Human Feedback, InstructGPT, ChatGPT und GPT-4 mitgearbeitet. Das ist eine ernstzunehmende Vita. Sie macht ihn aber nicht zum Mitgründer von ChatGPT: Das ist ein Produkt, kein Unternehmen, und Mitarbeit an einer Entwicklung ist etwas anderes als deren Gründung. Wir führen den Punkt hier auf, weil er ein brauchbarer Prüfstein ist. Wenn eine Quelle diese Zuschreibung ungeprüft übernimmt, lohnt sich ein zweiter Blick auf ihre übrigen Angaben. Tier 2
Zum Rest der Eckdaten: Der Start am 15. September 2026 fiel mit einer Seed-Runde über 40 Millionen US-Dollar unter Führung von DCVC zusammen, bei einer Bewertung von 200 Millionen. Das Modell ist transformerbasiert, wurde ausschließlich auf synthetischen Daten trainiert, und das Trainingsverfahren heißt „Reinforcement Learning for Calibrated Decisions“. Ein technisches Paper, die Gewichte oder eine Parameterzahl gibt es nicht. Tier 2
Warnsignal: Ein Modell, dessen zentrales Verkaufsargument gut kalibrierte Unsicherheit ist, und das gleichzeitig keine nachprüfbare Kalibrierungsmessung veröffentlicht, muss sich diese Frage gefallen lassen.
Welche Entscheidungen gehören an ein Entscheidungsmodell?
Ein Kandidat für ein System-One-Modell erfüllt nach unserer Erfahrung vier Bedingungen gleichzeitig:
Erstens: Die Entscheidung hat einen endlichen Ergebnisraum. Nicht „fasse diese Reklamation zusammen“, sondern „gehört diese Reklamation zu Kategorie A, B oder C“. Wenn Sie die möglichen Antworten nicht vorab aufschreiben können, ist es keine Entscheidung, sondern eine Aufgabe.
Zweitens: Sie fällt oft. Hundert Mal am Tag, nicht drei Mal im Monat. Bei drei Mal im Monat ist der Integrationsaufwand teurer als jede Einsparung.
Drittens: Der ganze nötige Kontext passt in eine Anfrage. Das Eingabebudget liegt bei rund 32.000 Tokens, also ungefähr 150.000 Zeichen. Das reicht für eine E-Mail-Kette, einen Vertrag oder einen Supportfall, nicht für eine Wissensdatenbank.
Viertens: Ein Fehler ist rückholbar oder wird abgefangen. Falsch einsortiert ist ärgerlich, falsch ausgezahlt ist ein Problem.
Vier Muster, die die Dokumentation beschreibt und die ich in echten Abläufen wiedererkenne:
- Intent Routing — Absicht klassifizieren und an den richtigen Handler weiterleiten. Typisch für Posteingang, Chatbot-Weichen und Ticketsysteme.
- Confidence-Gated Routing — die Confidence als Schalter zwischen automatisch und manuell. Typisch für Freigabeprozesse und Rechnungsprüfung.
- Composite Scoring — mehrere Bewertungsdimensionen zu einer Kennzahl verrechnen. Typisch für Lead-Qualifizierung und Priorisierung.
- Speculative Fan-Out — viele Fragen auf Verdacht mitschicken und nachher auswerten. Typisch für Dokumentenprüfung mit vielen Kriterien.
Der Klassiker in meinen Projekten ist der erste: Eine Support-Inbox, in der ein Sprachmodell für jede eingehende Nachricht entscheidet, in welche Warteschlange sie gehört. Dafür ein Frontier-Modell zu bezahlen, ist die teuerste Art, ein Dropdown zu bedienen.
Welche Entscheidungen gehören ausdrücklich nicht dorthin?
Die Abgrenzung ist wichtiger als die Anwendungsliste, weil hier die teuren Fehler entstehen.
Alles, wo die Begründung Teil des Ergebnisses ist. Ein Modell, das „Kategorie B, Confidence 0,87“ zurückgibt, kann Ihnen nicht sagen, warum. Wenn ein Mensch die Entscheidung später verteidigen oder ein Prüfer sie nachvollziehen muss, brauchen Sie die Begründung und damit ein Sprachmodell.
Mehrstufiges Abwägen, das sich nicht sauber zerlegen lässt. Hier ist eine Präzisierung nötig: Die Dokumentation beschreibt ausdrücklich, dass vielschichtige Fragen in atomare Einzelfragen zerlegt und anschließend nach festgelegten Regeln zusammengeführt werden können. Das ist ein gangbarer Weg und kein Ausschlusskriterium. Der Ausschluss greift erst dort, wo das Zerlegen selbst die eigentliche Denkarbeit ist, weil die Teilfragen sich gegenseitig bedingen. Dann gewinnen Sie nichts. Tier 1
Alles, was unter dem EU AI Act in eine höhere Risikoklasse fällt. Entscheidungen über Kreditwürdigkeit, Bewerberauswahl oder Zugang zu wesentlichen Dienstleistungen sind kein Spielfeld für ein Modell ohne veröffentlichte Kalibrierungsdaten, ohne Paper und ohne SLA. Das ist keine Rechtsberatung, sondern die naheliegende Vorsichtsregel.
Alles, wo Sie keine Referenzdaten haben. Ohne einen Datensatz mit bekannter richtiger Antwort können Sie nicht messen, ob das Modell bei Ihnen funktioniert. Und ohne diese Messung ist jede Einsparung geraten.
Der Hersteller formuliert die zugrundeliegende Gefahr in der eigenen Doku bemerkenswert offen: Ein Modell mit begrenztem Ausgaberaum kann immer noch selbstbewusst falsch liegen. Besonders dann, wenn der übergebene Zustand unvollständig ist oder die angebotenen Optionen nicht zur Realität passen.
Was kostet eine Entscheidung wirklich?
Der veröffentlichte Preis liegt bei 0,042 US-Dollar je Million Input-Tokens, ohne separate Abrechnung der Ausgabe. Tier 3 Angabe aus einem Early-Access-Test, nicht aus einer offiziellen Preisseite; eine solche war zum Zeitpunkt der Recherche nicht auffindbar.
In einem dokumentierten Testlauf ergab das rund 1,05 US-Dollar für die Klassifizierung von 9.840 Rechtsdokumenten, bei einem Durchsatz von 44,6 Dokumenten pro Sekunde. Tier 3
Die Vergleichszahlen zu Frontier-Modellen sollten Sie dagegen mit Abstand lesen. Der Gründer nennt 20- bis 200-fach schneller und 40- bis 400-fach günstiger; interne Benchmarks über vier Workflows kommen auf Spitzenwerte von 193,6-fach schneller und 444,6-fach günstiger. TypeSafe selbst merkt dazu an, dass eine Selektionsverzerrung möglich sei und die Werte gegen Durchschnittswerte von Frontier-Modellen gerechnet wurden, nicht gegen geprüfte Referenzdaten. Tier 2Tier 3
Übersetzt: Das sind Marketingzahlen mit Fußnote. Die Größenordnung ist plausibel: Ein spezialisiertes kleines Modell gegen ein generalistisches großes, das ist strukturell ein Faktor und kein Prozentsatz. Der konkrete Faktor in Ihrem Ablauf ist damit trotzdem nicht bekannt.
Rechnen Sie stattdessen selbst, und zwar in Entscheidungen statt in Tokens: Wie viele Weichenstellungen fallen pro Tag, was kostet eine heute, und was kostet die eine, die falsch war?
Warum ist Confidence der eigentliche Hebel?
Das ist der Teil, der in den Hype-Posts fehlt, und aus meiner Sicht der einzige, der langfristig zählt.
Jev gibt zu jeder Antwort die Wahrscheinlichkeitsverteilung über alle Optionen zurück und daraus abgeleitet einen Confidence-Wert zwischen 0 und 1. Konzentriert sich die Wahrscheinlichkeit auf eine Option, ist die Antwort sicher; verteilt sie sich, ist sie es nicht. Bei drei Optionen lautet die Formel (3 × größte Wahrscheinlichkeit − 1) / 2. Tier 1
Die Dokumentation empfiehlt eine Dreiteilung: über 0,9 automatisch handeln, zwischen 0,5 und 0,9 je nach Einsatz bestätigen lassen oder markieren, unter 0,5 an einen Menschen geben. Und sie fügt hinzu, dass diese Grenzen vom Einsatz abhängen. Eine Kontostandsabfrage darf eine niedrigere Schwelle haben als eine Überweisungsfreigabe. Tier 1
Warum das der Hebel ist, zeigt die Zahl aus dem Test an Rechtsdokumenten: 82,9 Prozent Gesamtgenauigkeit klingt nach zu wenig für den Produktiveinsatz. 93,7 Prozent bei Antworten ab 95 Prozent Confidence klingt anders. Der Unterschied liegt nicht im Modell, sondern in der Frage, was Sie mit den unsicheren Fällen machen.
Aus diesem Grund halten wir die Kategorie für relevanter als dieses eine Produkt. Ein Sprachmodell, das Ihnen „Kategorie B“ antwortet, klingt bei 51 Prozent Sicherheit exakt so überzeugt wie bei 99 Prozent. Ein Modell, das die Verteilung mitliefert, macht die Unsicherheit zu einer Zahl, an der Sie Ihren Prozess aufhängen können. Das ist ein Architekturvorteil, kein Modellvorteil. Er wird die Kategorie überleben, egal ob dieser Anbieter es tut.
Wie testet man das in zwei Wochen, ohne etwas kaputtzumachen?
Ein Vorgehen, das ohne Risiko für den laufenden Betrieb auskommt:
- Tage 1–2: Die Entscheidung isolieren. Suchen Sie den einen Punkt in einem Ablauf, an dem heute ein Sprachmodell etwas einsortiert. Schreiben Sie die möglichen Antworten vollständig auf. Wenn Ihnen das schwerfällt, ist der Kandidat der falsche.
- Tage 3–5: Referenzdaten bauen. 200 bis 500 echte Fälle mit der richtigen Antwort, von einem Menschen vergeben. Das ist der unangenehme Teil und der, den alle überspringen wollen. Ohne ihn messen Sie nichts.
- Tage 6–8: Schattenbetrieb. Das neue Modell läuft parallel mit, entscheidet aber nichts. Sie protokollieren nur: Antwort, Confidence, richtige Antwort.
- Tage 9–10: Kalibrierung prüfen. Zwei Auswertungen. Erstens die Trefferquote insgesamt. Zweitens, und das ist die wichtigere, die Trefferquote je Confidence-Band. Wenn Antworten mit 0,95 Confidence in Ihren Daten nur zu 70 Prozent stimmen, ist das Modell für Ihren Fall nicht kalibriert, und alle Schwellenwertempfehlungen sind wertlos.
- Tage 11–14: Schwelle setzen und begrenzt scharf schalten. Suchen Sie das Confidence-Band, in dem Sie Ihre gewünschte Genauigkeit erreichen, setzen Sie die Schwelle konservativ darüber, und lassen Sie alles darunter beim bisherigen Weg. Der Rest ist Beobachtung.
Der Hersteller empfiehlt in der eigenen Dokumentation dasselbe Vorgehen: konservativ anfangen, mit eigenen Daten testen, nachjustieren. Das ist ein gutes Zeichen. Es ändert nichts daran, dass die Arbeit bei Ihnen liegt.
Was spricht dagegen, jetzt schon umzubauen?
Eine ehrliche Gegenliste, bevor jemand auf die Idee kommt, das als Empfehlung zu lesen:
- Begrenzter Early Access seit 15. September 2026, keine veröffentlichten Rate Limits, kein Uptime-SLA zum Start. Für einen Produktivpfad ohne Rückfallebene ist das zu wenig.
- Kein Paper, keine Gewichte, keine Parameterzahl. Sie können die Kalibrierung nicht unabhängig nachvollziehen, nur an Ihren Daten nachmessen.
- Die unabhängige Datenlage ist dünn. Zwölf Passagen im einen Test und ein einzelner Dokumentendurchlauf im anderen sind ein Hinweis, keine Evidenz.
- Ein Anbieter mehr im Stack. Ein zusätzlicher Vertrag, eine zusätzliche Auftragsverarbeitung, eine zusätzliche Abhängigkeit. Bei EU-Datenschutz und einem US-Anbieter ohne veröffentlichte Angaben zum Verarbeitungsort ist das vorab zu klären.
- Die Kategorie ist eine Woche alt. Wenn das Muster trägt, werden die großen Anbieter eine vergleichbare Betriebsart nachliefern, und dann stellt sich die Anbieterfrage neu.
- Das Prinzip ist offenbar nachbaubar. In Entwickler-Communities kursieren bereits erste Open-Source-Umsetzungen desselben Grundgedankens, aufgesetzt auf deutlich kleineren, frei verfügbaren Modellarchitekturen. Tier 3 Das relativiert die Anbieterfrage, verstärkt aber zugleich das Argument für die Analyse: Wer heute Zeit investiert, sollte sie in die Entscheidungs-Inventur stecken und nicht in die Auswahl eines Anbieters, dessen Kategorie in zwölf Monaten möglicherweise von mehreren Seiten bedient wird.
Was wir trotzdem jetzt schon empfehlen: die Entscheidungen in Ihren Abläufen einmal sauber zu inventarisieren und von der Textarbeit zu trennen. Diese Analyse gilt unabhängig davon, welches Modell sie am Ende ausführt, und sie ist in fast jedem Fall der Punkt, an dem die tatsächlichen Kosten sichtbar werden.
Key Takeaways
- Trennen Sie im Ablauf, was entschieden wird, von dem, was geschrieben wird. Diese Inventur ist unabhängig vom Anbieter wertvoll und meist der Punkt, an dem die echten Kosten sichtbar werden.
- Vier Kriterien für einen guten Kandidaten: endlicher Ergebnisraum, hohe Häufigkeit, Kontext passt in eine Anfrage, Fehler ist abfangbar.
- Nicht dorthin gehören begründungspflichtige Entscheidungen, mehrstufiges Abwägen, Hochrisiko-Anwendungsfälle nach EU AI Act und alles, wofür Ihnen Referenzdaten fehlen.
- Confidence ist der eigentliche Gewinn, nicht die Geschwindigkeit: Der Sprung von 82,9 auf 93,7 Prozent im externen Test kam allein daraus, unsichere Antworten auszusortieren.
- Kalibrierung gilt nur für Ihre Daten. Fremde Schwellenwerte sind Startwerte, keine Ergebnisse.
Häufige Fragen
Weiterführende Beiträge


Ihre Abläufe einmal durchleuchten lassen
Sieben Dimensionen, 35 Fragen — inklusive der Frage, welche Entscheidungen in Ihren Abläufen heute ein Sprachmodell übernimmt.
Jetzt eigenen KI-Reifegrad checkenDie Entscheidungs-Inventur aus diesem Beitrag ist der erste Schritt jeder Prozessanalyse bei never lost: Wir gehen einen realen Ablauf durch und trennen auf, was entschieden und was geschrieben wird. Am Ende steht eine Liste mit Kandidaten, Mengengerüst und Kostenschätzung — unabhängig davon, welches Modell sie später ausführt.